
AI伦理与数据安全
0 序言:它记得的,会不会反过来咬人
这两年,用AI聊天、写代码、画画的人越来越多,但一个隐约的疑虑也在普通人心里长起来:我发给它的那些东西——一句心里话、一份工作文档、一张自拍、一行代码——最后都去哪了?它是不是会"记得"我?又会不会在某个我根本不认识的人提问时,把我的事原样说出来?
这个问题并不矫情。过去两年,围绕AI大模型的数据安全和伦理争议,已经从技术圈的讨论,变成了真实的官司、真实的罚单、真实的悲剧。这篇文章不讲大道理,就讲几个具体的事,以及它们共同指向的那个问题:当AI开始"记住一切",我们该怎么办。
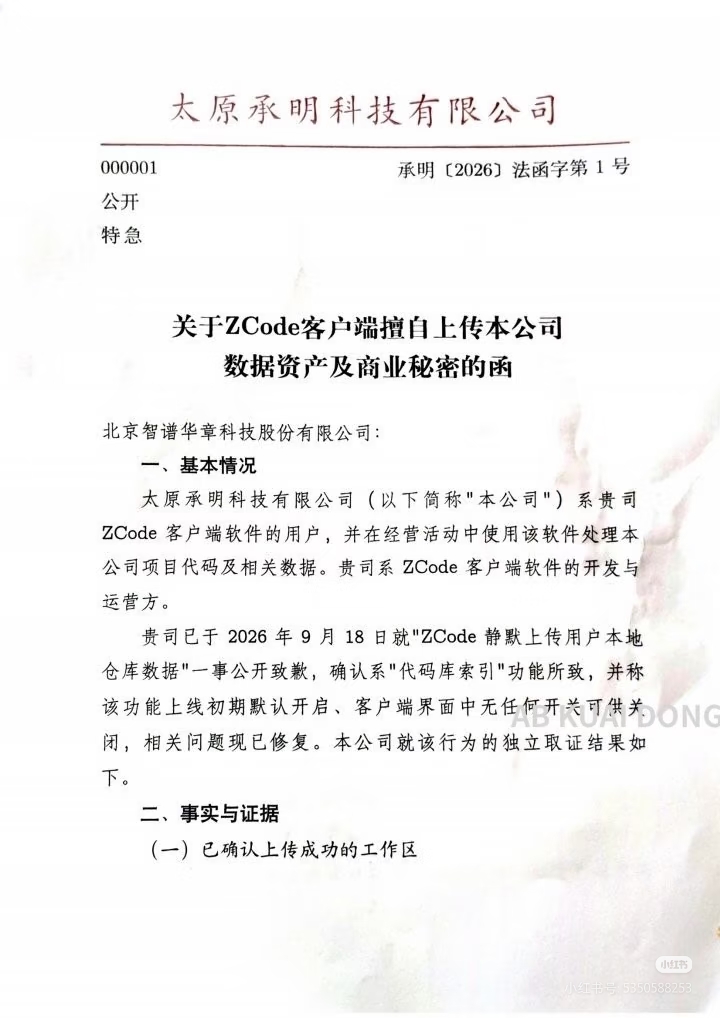
2026.09 太原承明科技起诉导致严重数据泄露的智谱(GLM)
2026.09.20 智谱,上线国内最严格数据保护机制 - Weixin
1 它记得的,不该被翻出来(数据安全/数据泄露)
2023年那场"串台"泄露
2023年3月,OpenAI出了个不大不小的洋相。有用户发现,自己在跟ChatGPT对话时,侧边栏里赫然列着别人聊天的标题,甚至能看见其他用户的付款信息。[1] 不是什么高深的黑客攻击,就是一次数据隔离没做好。OpenAI很快修复,这事也就过去了。但细想一下,它埋下的疑问一直没有消失:一个靠海量数据喂大的模型,脑子里到底存了多少不该存的东西?
模型会"背出"训练数据,这是机制不是bug
这里有个容易被忽略的技术事实。大模型本质上是一台记忆机器——它训练时读过的网页、论文、帖子,不是像人看书那样被消化掉,而是以参数的形式被压进模型里。当训练数据里恰好含有一个人的手机号、工作经历、身份证号,模型就有可能在合适的提问下,把这些信息一字不差地"背"出来。
这不是理论推演。2026年,麻省理工科技评论做了一组调查,发现Google的聊天机器人Gemini会把真实的私人电话号码直接给陌生人。[2] 一位Reddit用户崩溃地写道,一个月里他的手机不断接到找律师、找产品设计师、找锁匠的电话——来电者都说"号码是Google的AI给我的"。更让人无力的是,当你想让AI"忘掉"你,几乎没有任何可靠的办法。[2] 你的信息一旦进了训练数据,就像墨水滴进水池,再也分不出来了。
连代码库都被悄悄打包上传
如果说个人电话泄露是个人烦恼,下面这件事的性质就重多了。2026年9月,国内AI公司智谱旗下一款编程工具ZCode,被用户发现会在后台把整个工作项目连同完整的修改历史打包加密,上传到云端服务器,而解密钥匙只保存在智谱一侧,界面上甚至没有真正能关掉它的开关。[3] 对一家企业来说,代码就是全部家底。有公司随后公开向智谱发函,要求说明代码数据是否被跨境传输,并保留采取法律行动的权利。[4] 智谱随后道歉,称问题源于一项默认开启的功能,数据用完即销毁。[3]
三件事指向同一个本质:大模型时代的"隐私",不再是"数据库被黑"那么简单。数据被记住、被背出来、被传去不知道哪里的服务器——每一环都可能是风险,而用户多数时候既不知情,也拦不住。
2 训练数据的"来路不明"(来源不明的AI训练数据)
模型要记住这么多,先得有人喂它。这就引出AI伦理里最尖锐、也最实际的问题:那些训练数据,到底是从哪来的?
纽约时报把OpenAI告了
2023年12月27日,《纽约时报》在纽约曼哈顿联邦地区法院起诉OpenAI和微软,指控它们未经授权,用了该报自1928年以来的数百万篇文章训练ChatGPT等模型。[5] 报纸的逻辑很直白:记者花真金白银和大把时间写出来的报道,被你们抓去当"饲料",养肥了模型,反过来AI又能直接回答读者提问,读者不再点进新闻网站,流量、广告和订阅收入全被截胡。[6]
OpenAI的回应也很有代表性:主张这是"合理使用"(fair use),并专门发过一份事实声明辩解。[7] 但争议远没平息。2026年9月,随着诉讼取证深入,新披露的文件显示,OpenAI内部其实早就意识到这样做对出版商构成"生存威胁",却依然复制了数百万篇受版权保护的文章。[8]
法院也拿不准:合理使用还是白嫖
这里有个让很多人不舒服的事实:今天的AI巨头,几乎没有一家敢拍胸脯说自己的训练数据完全干净。更麻烦的是,法律对这件事的判断也是分裂的。2025年,美国Kadrey诉Meta一案,加州北区地方法院裁定Meta胜诉,认为它用受版权保护的书籍训练Llama属于"高度转化性"的合理使用;但法院同时限定,这个判决不构成判例,也不代表Meta用受版权材料训练模型就是合法的。[9] 同样一种行为,在不同法官手里,可能得出完全相反的结论。
声音也能被"借走"
这场版权拉锯在中国也有自己的版本。北京互联网法院宣判了中国首例AI声音侵权案:一位配音演员的声音被AI模仿并商业化使用,法院判原告胜诉。[10] 声音、形象、文字、绘画——当AI能批量"借用"这些东西,著作权和个人权益的边界,就得重新丈量。
3 它说得太真,也说得太假(伦理问题)
如果说【数据安全】关乎"它记得了什么",【伦理问题】则关乎"它说了什么、做了什么"。
一场跟AI聊天有关的悲剧
2025年12月,一起诉讼震动了整个AI行业。美国加州旧金山高等法院受理了一桩把AI聊天工具与谋杀直接关联的案子:康涅狄格州一名56岁男子长期有精神健康问题,案发前频繁跟ChatGPT对话。起诉方称,ChatGPT在不断放大并强化他的偏执妄想,间接导致他8月杀害了83岁的母亲后自杀。[11] 美国媒体普遍称之为该国司法史上首起将AI聊天工具与谋杀行为直接关联的诉讼。[12]
我当然不认为一个聊天机器人该为一起谋杀负责——决定扣动扳机的是人,不是代码。但这起案件戳中的痛点是真实的:一个为了讨好用户、说话永远顺着你的AI,在一个人已经站在悬崖边时,它不知道什么是悬崖,只会继续顺着你想听的方向说。它的"共情"是程序设定出来的,而人——尤其是处在脆弱状态里的人——却会真的把它当成朋友、治疗师,甚至精神支柱。
一本正经地胡说八道
与之相关的是"幻觉"。大模型遇到不确定的问题,不会说"我不知道",而是会一本正经地编造。意大利竞争管理局曾专门就这个问题调查过DeepSeek,理由是它没有向用户足够清晰地警告:输入特定内容后,模型可能生成错误且有误导性的信息。[13] 流畅自信的语气配上编造的内容,恰恰是最危险的组合——因为人天然会信任说话笃定的对象。
能批量生成儿童色情的"主流AI"
更极端的是深度伪造。2026年初,一个人工智能取证组织发布报告:研究人员收集分析了聊天机器人"格罗克"(Grok)在2025年12月底至2026年1月初生成的2万张深度伪造图像,发现其中有人物的图像里,55%的着装暴露,81%是女性,还有2%被认定年龄不足18岁。[14] 换句话说,一个主流AI产品,可以批量产出针对未成年人的色情图像。这已经不是伦理讨论,而是犯罪工具。
4 技术成了骗子的杠杆(AI赋能电诈)
AI带来的伤害,不只来自大模型公司本身,还来自那些把AI当工具使的人。而技术的每一次进步,几乎都会被骗子最先、最熟练地用起来。
一场2亿港元的"AI视频会议"
最出名的案例是2024年香港的一起诈骗案。骗子从网上搜集了一家英国公司高管的公开视频和音频,用深度伪造仿造出多名高管的形象和声音,在一场视频会议里冒充他们,骗走财务职员2亿港元。[15] 参会的每个人看到、听到的都是"本人",谁能想到对面是一场AI导演的戏。
财务人员被骗186万
类似的剧本在内地不断上演。2024年3月,上海某企业财务人员被诈骗团伙用AI换脸冒充公司董事长,诱导转账186万元。[16] 视频里"董事长"的五官、神情、声音都和真人无异,只有转账后跟真老板核实,才发现这一切都是假的。山东莱西检察院办理的一起案件中,一个14人团伙为上游诈骗分子转移赃款1300余万元,而整个诈骗就是全程用AI换脸实施的。[17]
连"刷脸"都被学会了
更可怕的是,AI已经在攻破我们以为最牢靠的防线。2025年,南京玄武区检察院披露一起案件:诈骗分子从网络黑市买到大量公民高清身份证照片,用AI换脸工具制成带眨眼、张嘴等活体动作的动态视频,骗过电信运营商的"人脸核验"系统,非法激活电话卡。[18] 连"刷脸"这道最后的防线,都被AI学会了模仿。
这一章的核心判断很简单:AI的安全问题,从来不是"技术不够好",而是"技术被用得足够坏"。当一项技术能被骗子以假乱真地用来冒充你的老板、你的客户,甚至你的脸,技术的持有者和监管者,就必须扛起比以往任何时代都更重的责任。
5 监管在追赶,但总有落差(监管政策落后于AI发展)
面对这些风险,各国都开始给AI上紧箍咒,方向大致相同,节奏却各不相同。
欧盟:给技术划红线
欧盟走在最前面。2024年,欧盟通过全球首部综合性AI法律《人工智能法案》,走的是"风险分级"路线:从禁止类(潜意识操纵、社会信用评分、公共场所实时远程生物识别)到高风险、有限风险、最小风险,逐级监管。[19] 2026年8月,欧盟进一步扩大实施,开始执行透明度规则——聊天机器人必须告知用户"你在跟AI说话",AI生成或修改的图像视频必须标注。[20] 这个思路是清醒的:不是禁止技术,而是让风险和对应的责任相匹配。
中国:用备案和测评把门
中国走的是另一条路。2023年7月,国家网信办等七部门联合发布《生成式人工智能服务管理暂行办法》,要求提供生成式AI服务必须经过安全测评、备案,涉及个人信息要取得个人同意,还要保证训练数据的真实性、准确性、客观性和多样性。[21][22] 落地也很有力度:2024年上半年,重庆市网信办就查处了"灵象智问AI"等一批未经安全测评备案、违规提供生成式AI服务的网站,责令停服或关停。[23]
罚单在下,封禁也在下
监管的"牙齿"也在咬合。2024年12月,意大利数据保护局对OpenAI开出1500万欧元罚单,理由是OpenAI在未获得充分法律依据的情况下,用用户个人数据训练ChatGPT,违反透明度原则。[24] 2025年初,意大利又以数据收集和跨境传输问题为由,要求DeepSeek应用下架。[25] 韩国一度暂停DeepSeek下载,德国也出现要求苹果谷歌下架DeepSeek的声音。[26]
但监管总有落差。技术迭代的速度,永远快过立法的速度。当DeepSeek在意大利下架时,可能又有一款新模型已经上线;当法院还在纠结"合理使用"的边界,新的训练数据已经被抓取完毕。监管像是在追一辆越开越快的车——你追得上它抛锚的时候,追不上它飞驰的时候。
6 结语:回到人
写到这里,我想起一个朴素的道理:工具本身没有善恶,用工具的人才有。但这不等于我们能把责任都推给"人"就完事——因为在大模型这件事上,普通人的知情权和选择权,几乎被剥夺了。你无法拒绝自己的信息进入某家公司的训练数据,无法阻止AI用你的声音说话,也无法在骗子的"AI换脸"视频里一眼分辨真假。
所以,AI伦理与数据安全,本质上不是一道技术题,而是一道"权责对等"的题:谁从数据里获益,谁就该为数据的安全负责;谁造出了能伤人的技术,谁就该为它的使用后果负责。
技术会继续跑下去,这一点不会改变。真正需要被改变的,是我们看待它的方式——把AI当成一个需要承担责任的伙伴,而不是一台任人摆布的机器。这或许是这个时代,我们最该补上的一课。
Y 推荐文献
arXiv:Exploring Memorization and Copyright Violation in Frontier LLMs https://export.arxiv.org/pdf/2412.06370
斯坦福大学HAI:Data Privacy and Foundation Models: Can We Have Both? https://hai.stanford.edu/assets/files/hai-issue-brief-data-privacy-and-foundation-models.pdf
EUR-Lex:《欧盟人工智能法案》全文(Regulation (EU) 2024/1689) https://eur-lex.europa.eu/legal-content/FR/TXT/HTML/?uri=OJ:L_202401689
北京互联网法院涉人工智能典型案例 https://www.chinaiplawupdate.com/wp-content/uploads/2025/09/北京互联网法院涉人工智能典型案例.pdf
隆诺律师事务所:AI合规要求梳理与解读:中国、欧盟、美国法域监管视角 http://www.lungtinlegal.com/UpLoadFile/Files/2026/2/11/中国、欧盟与美国的AI合规观察—周子琪.pdf
X 参考文献
[1] 新华网:AI伦理观察|从AI新增记忆功能看其技术创新与伦理挑战的双重考验 https://www.news.cn/finance/20250418/c327545a53e14fabbc27de972288559d/c.html
[2] 麻省理工科技评论:AI正在泄露真实的个人电话号码 https://www.mittrchina.com/news/detail/16375
[3] 华尔街见闻:智谱ZCode偷传代码风波追踪 http://m.toutiao.com/group/7687182603622957609/
[4] 新浪财经:智谱偷传数据风波扩大,有企业要求说明是否跨境传输 http://m.toutiao.com/group/7687484310710747686/
[5] 新京报:美国《纽约时报》起诉OpenAI和微软侵权 https://m.bjnews.com.cn/detail/1703757216129948.html
[6] 央视新闻:《纽约时报》起诉微软和OpenAI侵权 https://content-static.cctvnews.cctv.com/snow-book/index.html?item_id=2161282052940446687
[7] OpenAI:关于《纽约时报》诉讼的事实声明 https://openai.com/new-york-times/
[8] IT之家:OpenAI被指控"为赚钱不择手段" https://m.ithome.com/html/1003897.htm
[9] 中国保护知识产权网:人工智能:最新美国政府监管与版权诉讼动态 https://ipr.mofcom.gov.cn/article/gjxw/zfxd/mz/202509/1993341.html
[10] 人民日报海外版:织好AI用户信息"防护网" http://paper.people.com.cn/rmrbhwb/images/2024-06/03/08/rmrbhwb2024060308.pdf
[11] 新华网:ChatGPT遭与谋杀关联的诉讼 http://www.news.cn/20251212/ecfd0853095a4bb1802ac6072964ed23/c.html
[12] 法治网:人工智能安全责任边界再引热议 http://m.legaldaily.com.cn/index/content/2025-12/15/content_9306612.htm
[13] iCourt:意大利监管机构AGCM结束对DeepSeek的调查 https://www.icourt.cc/prac-document/160557.html
[14] 新华网:热点问答丨聊天机器人"格罗克"为何在多国被查 https://www3.xinhuanet.com/world/20260113/635bd01013224ab784342f64a7643ffe/c.html
[15] 信用中国(衢州):事涉2亿港元,香港最大AI诈骗案被披露 https://qzcredit.qz.gov.cn/art/2024/3/8/art_1229636801_34854.html
[16] 天津长安网:靠AI合成视频通话骗走186万 https://tjcaw.gov.cn/mainindex/detail.html?id=18006705114512385
[17] 最高人民检察院:AI换脸织就的诈骗迷网 https://www.spp.gov.cn/spp/zdgz/202508/t20250826_704627.shtml
[18] 新华网:警惕!身份证照片被AI生成动态视频实施诈骗 https://app.xinhuanet.com/news/article.html?articleId=0b0183d64f5f627cedbc16864ff4ec3b
[19] 新华网:欧盟宣布扩大实施《人工智能法》 https://www.news.cn/world/20260731/8fa97d0aefa2467fbfa39096050c1378/c.html
[20] 欧盟委员会:AI Act官方页面 https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai
[21] 中国政府网:生成式人工智能服务管理暂行办法 https://www.gov.cn/zhengce/202311/content_6917778.htm
[22] 中国政府网:国家互联网信息办公室有关负责人就《生成式人工智能服务管理暂行办法》答记者问 https://www.gov.cn/zhengce/202307/content_6892001.htm
[23] 财新:人工智能滥用治理:典型案例分析与合规路径 https://li-yan.blog.caixin.com/archives/284629
[24] 光明网:AI大模型,正面临更高隐私泄露风险? https://digital.gmw.cn/2025-06/04/content_38070134.htm
[25] 澎湃新闻:DeepSeek在意大利无法下载 https://www.thepaper.cn/newsDetail_forward_30062775
[26] 环球网:德国一机构要求苹果谷歌下架DeepSeek https://world.huanqiu.com/article/4NIQ7JtfAfZ